php2shell : dans les coulisses d'une course contre la montre
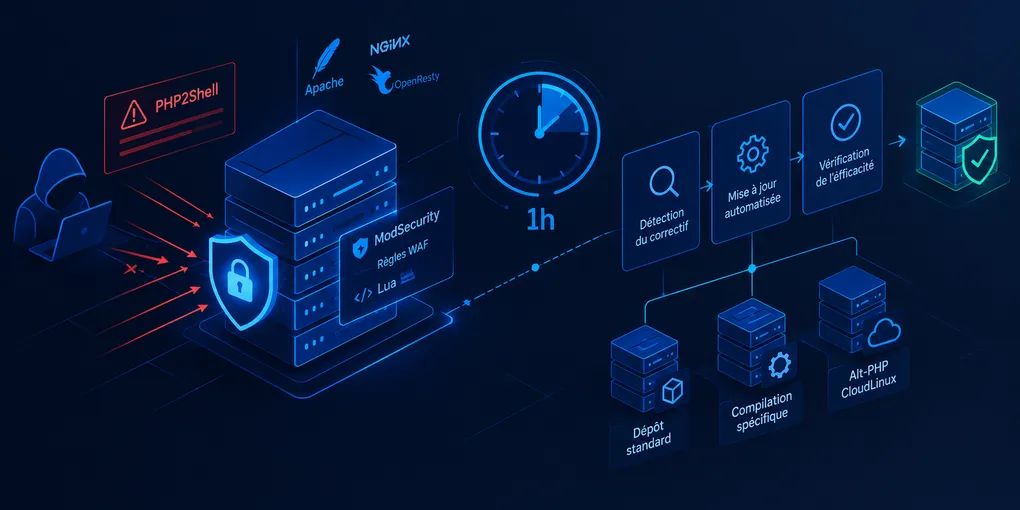
Le 20 octobre 2026, PHP a annoncé l’arrivée imminente d’un correctif de sécurité pour deux failles, CVE-2026-109618 et CVE-2026-109619, surnommées php2shell. Le ton employé et le peu d’informations transmises dans l’annonce laissaient présager une ampleur suffisante pour que le monde entier s’active à préparer la mise à jour.
L’incident de sécurité
Ces failles de sécurité ont été rapportées indépendamment par un chercheur chez Calif.io le 11 août 2026 dans le cadre du programme Patch The Planet, par la firme de cybersécurité israélo-américaine Wiz le 24 août 2026 et par OpenAI le 18 septembre 2026.
Comme pour la plupart des failles de sécurité, dont les plus dangereuses, l’éditeur (ici, The PHP Foundation) a pour usage de garder l’information confidentielle le temps de préparer un correctif et de coordonner efficacement son déploiement.
Les développeurs ont ainsi mis plusieurs acteurs importants dans la confidence, afin de préparer la divulgation simultanée et surtout pour que la majorité des serveurs concernés puissent être patchés avant même que l’information ne soit publique. On compte notamment parmi eux Cloudflare, qui développait une protection au niveau de la couche réseau depuis début octobre 2026 et l’a déployée dès le 21 octobre 2026 à 3h UTC, soit 11 heures avant la sortie des versions PHP incluant les correctifs.
Fuite d’informations
Malheureusement, le 20 octobre 2026 à 15h UTC, soit 23 heures avant la sortie prévue, les numéros CVE ont commencé à circuler sur divers forums et réseaux sociaux. C’est d’ailleurs ainsi que l’information m’est parvenue pour la première fois.
Aucun détail technique n’avait encore été publié, mais la teneur de la situation s’est confirmée avec la sortie de l’annonce officielle de PHP à 19h30 UTC. C’est à partir de cet instant que j’ai commencé à être sollicité pour planifier et coordonner la sécurisation de divers sites et applications, allant d’un simple blog personnel à des infrastructures complexes de fournisseurs cloud, en passant par des sites institutionnels.
Quelques heures plus tard, certaines personnes ont commencé à faire fuiter également les recommandations de sécurité transmises par PHP aux fournisseurs d’infrastructures critiques. À ce stade, les informations techniques commençaient à apparaître.
Mon rôle a donc été d’identifier la pertinence des recommandations, et de les appliquer, si nécessaire. Ces recommandations n’émanant pas d’une seule source de confiance, j’ai commencé par évaluer leur impact.
Selon l’infrastructure cible, j’ai appliqué différentes mesures :
- Déjà plusieurs semaines avant l’incident, j’ai entamé le passage de plusieurs sites de PHP vers Astro (dont ce site), éliminant ainsi la dépendance à PHP. Je me suis assuré que PHP n’était plus du tout en exécution sur ces environnements.
- Sur certains sites PHP, il m’a été possible de bloquer de manière préventive certaines requêtes : bloquer toute requête autre que GET et HEAD excepté l’espace administrateur et les formulaires de contact, restreindre cet espace administrateur à quelques adresses IP, bloquer les requêtes avec des query strings… J’ai ainsi conçu des règles WAF sur-mesure (ModSecurity pour les infrastructures utilisant Apache HTTPd Server et du code Lua pour les infrastructures utilisant Nginx) afin de limiter en amont du réseau les actions possibles.
- J’ai également profité de la mise en cache (Varnish et Cloudflare) en optimisant au maximum le ratio HIT/MISS, afin qu’une requête ait plus de chance de tomber sur une page PHP déjà rendue, plutôt que d’exécuter PHP. Combinée au filtrage des query strings et des méthodes HTTP, ainsi qu’aux autres règles, cette mesure limitait les points d’entrée vers PHP.
- Dans certains cas extrêmes, il a été estimé plus prudent de désactiver totalement l’accès au site web pendant quelques heures voire quelques jours.
Préparation de la mise à jour
N’oublions pas l’essentiel : l’annonce initiale avait pour but de nous préparer pour que la mise à jour soit appliquée le plus vite possible. Là encore, divers chemins ont été proposés.
Dans la majorité des cas, les serveurs reposent sur les paquetages fournis par leur distribution Linux. J’ai ainsi vérifié si ces distributions étaient au courant de l’annonce. Une grande majorité avaient déjà des discussions actives sur le sujet. Pour ces serveurs, la préparation a été plutôt simple :
- Voir sur quel miroir ils s’appuyaient et vérifier la date de dernière synchronisation du miroir.
- Tester une mise à jour depuis ce miroir.
- Concevoir un script de mise à jour automatisée et planifier son exécution.
Une poignée des serveurs dont je m’occupe utilisent des versions PHP compilées depuis leur source, avec pour certains d’entre eux des backports et des modifications spécifiques. Pour s’assurer qu’à la sortie de la mise à jour, la compilation se termine correctement, j’ai testé en conditions réelles la compilation de la dernière version PHP disponible, celle qui était encore vulnérable.
Et là, le drame. Certains de ces serveurs n’avaient pas assez de ressources pour compiler PHP rapidement. Pour anticiper ce besoin, j’ai décidé de prendre des instances Google Compute Engine pour procéder aux compilations.
Cette technique fut particulièrement utile, notamment pour les images Docker qui reposaient sur GitHub Actions pour leur compilation, alors que GitHub Actions était aussi récemment en panne. J’ai donc décidé de ne pas m’appuyer sur les sorties de version de hub.docker.com mais de préparer mes propres images et j’ai eu raison : du retard a été constaté sur la sortie des images Docker.
En concevant un script, j’ai pu compiler plusieurs versions de PHP pour plusieurs distributions et architectures en parallèle et procéder à leur déploiement en moins de 5 minutes. La facturation horaire des cloud providers reste un pain béni pour accéder à des machines ultra-performantes pour des besoins ponctuels comme celui-ci.
Enfin, pour les sites dont l’accès a dû être désactivé, j’ai préparé les scripts nécessaires pour automatiser le maximum de tests et d’actions pour faciliter la réactivation.
Exécution de la mise à jour
Une fois la version corrigée disponible, les routines préparées permettaient de déclencher son déploiement sans attendre une intervention manuelle répétitive sur chaque serveur. J’ai ainsi mis à jour ou patché près de 100 000 sites web et applications dans l’heure suivant la sortie.
Malheureusement, CloudLinux tardait à sortir ses mises à jour, ce qui a retardé la mise en place du correctif sur d’autres sites et causé quelques frustrations du côté de certains hébergeurs web. Fort heureusement, le dépôt TuxCare a sorti des paquetages PHP compatibles CloudLinux et j’ai ainsi basculé certains serveurs concernés sur ce dépôt, notamment ceux dont l’accès n’avait pas été coupé.
J’aurais sincèrement aimé avoir CloudLinux dans la confidence, comme Cloudflare et les autres acteurs majeurs. CloudLinux est une entreprise sérieuse et qui est un pilier dans l’industrie de l’hébergement web. Avoir mis CloudLinux dans la confidence aurait pu accélérer considérablement la sortie des versions PHP sur leurs systèmes d’exploitation.
Ce que je retiens de cet incident
Avec le recul, ce n’est pas le jour de la sortie du correctif qui a fait la différence, mais tout ce qui avait été mis en place avant.
Préparer avant l’urgence. Les scripts de mise à jour, les tests de compilation et les machines de build étaient prêts avant la publication des versions corrigées. C’est ce qui m’a permis de patcher près de 100 000 sites dans l’heure, au lieu d’intervenir serveur par serveur.
Se protéger sans attendre le correctif. Près d’une journée s’est écoulée entre la fuite des numéros CVE et la sortie des versions corrigées. Les règles WAF, la restriction des espaces d’administration et le cache ont permis de réduire l’exposition pendant cette fenêtre.
Ne pas dépendre d’une seule chaîne de distribution. Paquets des distributions, compilations maison, images Docker en retard, CloudLinux à la traîne : aucune solution unique n’aurait suffi. Avoir des alternatives (TuxCare, mes propres images, des machines louées à l’heure) a fait gagner de précieuses heures.
Remettre l’architecture en question. Les sites migrés vers Astro quelques semaines plus tôt n’ont tout simplement pas été concernés. Parfois, le meilleur correctif reste de ne plus avoir le composant vulnérable.
La sécurité commence avant la publication de la faille.